F5 BIG-IP LTM การกระจายโหลด: แนวคิดการตั้งค่าตั้งแต่ VLAN จนถึง Failover

F5 BIG-IP Local Traffic Manager (LTM) วางอยู่หน้ากลุ่มเซิร์ฟเวอร์และกระจายคำขอของไคลเอนต์ไปยังเซิร์ฟเวอร์เหล่านั้น มันตรวจว่าเซิร์ฟเวอร์ตัวใดพร้อมใช้งาน ทำให้คำขอที่เกี่ยวข้องไปยังเซิร์ฟเวอร์เดิมเมื่อจำเป็น ถ่ายโอนการถอดรหัส TLS และสลับไปยังเครื่องสแตนด์บายโดยอัตโนมัติ บทความนี้พาคุณตั้งค่าตามลำดับที่จะเจอ ได้แก่ หน้าที่ของ LTM การวางแผนการออกแบบ การเข้าถึงครั้งแรกและเครือข่าย พูลและ health monitor virtual server วิธีกระจายโหลดและ persistence การถ่ายโอน SSL High Availability และการแก้ปัญหา ตัวอย่างการตั้งค่าแสดงคำสั่ง tmsh ของแต่ละขั้น
สิ่งที่ต้องเตรียม
ควรรู้ IP แอดเดรส ซับเน็ต VLAN และรู้ว่าเราเตอร์กับสวิตช์ทำอะไร ควรอ่านบทความ CCNA และแนวคิดการกระจายโหลดในบทความ FortiGate บนเว็บนี้ก่อน การฝึกควรใช้เครื่อง BIG-IP ในแล็บหรือ virtual edition ทำกับเครื่องที่คุณเป็นเจ้าของหรือได้รับอนุญาต และอย่าเปลี่ยน load balancer ในระบบใช้งานจริงโดยไม่มีแผนที่เขียนไว้และแผนย้อนกลับ
ภาพประกอบ
หัวข้อที่ 1: BIG-IP LTM ทำอะไร
load balancer ทำให้กลุ่มเซิร์ฟเวอร์ดูเหมือนเป็นบริการเดียว ไคลเอนต์เชื่อมต่อกับแอดเดรสเดียว และ LTM ตัดสินว่าเซิร์ฟเวอร์ใดจะรับคำขอแต่ละคำขอ วิธีนี้เพิ่มความจุ ทำให้ถอดเซิร์ฟเวอร์ออกเพื่อบำรุงรักษาได้โดยไม่ดับบริการ และซ่อนความล้มเหลวของเซิร์ฟเวอร์จากผู้ใช้ LTM ทำงานที่ชั้น transport และชั้น application จึงใช้รายละเอียดของ TCP และเนื้อหา HTTP ในการตัดสินใจได้
ทำไมต้องใช้ load balancer
เว็บเซิร์ฟเวอร์หนึ่งตัวรองรับผู้ใช้ได้จำกัด การเพิ่มเซิร์ฟเวอร์จะช่วยได้ก็ต่อเมื่อมีตัวกระจายคำขอไปยังเซิร์ฟเวอร์เหล่านั้น LTM กระจายโหลด ตรวจแต่ละเซิร์ฟเวอร์ และหยุดส่งทราฟฟิกไปยังเซิร์ฟเวอร์ที่ล่ม ผู้ใช้เห็นแอดเดรสเดียว และทีมเปลี่ยนเซิร์ฟเวอร์ได้โดยไม่ต้องเปลี่ยนแอดเดรส
Local traffic management และผลิตภัณฑ์ F5 อื่น
LTM กระจายทราฟฟิกภายในศูนย์ข้อมูล Global Traffic Manager (GTM ซึ่งปัจจุบันเรียกว่า DNS-based load balancing) เลือกระหว่างศูนย์ข้อมูล Application Security Manager (ASM ซึ่งปัจจุบันเรียกว่า Advanced WAF) เพิ่มฟีเจอร์ web application firewall เรียนรู้ LTM ก่อน เพราะออบเจกต์เดียวกัน เช่น pool และ virtual server ถูกใช้ในผลิตภัณฑ์อื่นด้วย
เส้นทางของข้อมูล
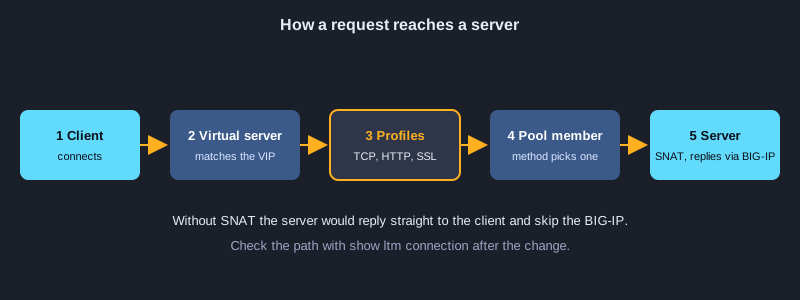
คำขอเข้าสู่แอดเดรสของ virtual server ผ่านโปรไฟล์ ถูกจับคู่กับ pool และส่งไปยังสมาชิก การตอบกลับของสมาชิกกลับมาผ่าน BIG-IP ซึ่งเป็นเหตุผลว่าทำไม BIG-IP ต้องอยู่บนเส้นทางระหว่างไคลเอนต์กับเซิร์ฟเวอร์ หรือจัดการทราฟฟิกขากลับด้วย SNAT
หัวข้อที่ 2: วางแผนการออกแบบก่อนตั้งค่า
ระบบ load balancer ล่มส่วนใหญ่มาจากการออกแบบที่ไม่มีใครเขียนไว้ ไม่ใช่จากตัวอุปกรณ์ ก่อนเปิดเครื่องมือการตั้งค่า ให้วางแผนเครือข่าย เซิร์ฟเวอร์ การตรวจสุขภาพ และการสลับกลับ
วาดแนวคิด
วาดไคลเอนต์ เครือข่ายภายนอก BIG-IP เครือข่ายภายในที่มีเว็บเซิร์ฟเวอร์ และเครื่องสแตนด์บาย ติดป้ายแต่ละพอร์ตด้วย VLAN และแต่ละแอดเดรสด้วยหน้าที่ ได้แก่ แอดเดรส virtual server, self IP, แอดเดรสเซิร์ฟเวอร์ และแอดเดรสการจัดการ แผนภาพนี้เป็นอ้างอิงของทุกขั้นตอนถัดไป
เขียนแผนแอดเดรส
บันทึกแอดเดรส virtual server ที่ผู้ใช้เชื่อมต่อ self IP ของแต่ละ VLAN แอดเดรสของเซิร์ฟเวอร์ default gateway และแอดเดรสการจัดการ เก็บเครือข่ายการจัดการแยกจากเครือข่ายทราฟฟิก การเปลี่ยนแอดเดรสภายหลังจะง่ายเมื่อออบเจกต์ที่ขึ้นกับมันถูกระบุไว้ครบ
ตัดสินว่าจะตรวจเซิร์ฟเวอร์อย่างไร
กำหนดว่าเซิร์ฟเวอร์ที่ทำงานปกติหมายถึงอะไรสำหรับแต่ละบริการ เว็บเซิร์ฟเวอร์ตรวจได้ด้วยคำขอ HTTP ไปยังหน้าสุขภาพ ฐานข้อมูลตรวจได้ด้วยการเชื่อมต่อ TCP การตรวจที่ทดสอบเพียงพอร์ตอาจทำให้แอปพลิเคชันที่เสียถูกมองว่าปกติ จึงควรทดสอบสิ่งที่ผู้ใช้ต้องการจริง
วางแผนการย้อนกลับ
บันทึกการตั้งค่าก่อนการเปลี่ยนแปลงครั้งแรก และจดวิธีกู้คืน วางแผนช่วงบำรุงรักษาสำหรับการเปลี่ยนที่ย้ายทราฟฟิกที่ใช้งานอยู่ และแจ้งผู้ที่พึ่งพาบริการนี้
หัวข้อที่ 3: การเข้าถึงครั้งแรก VLAN self IP และการกำหนดเส้นทาง
BIG-IP ใหม่ต้องมีชื่อเครื่อง DNS NTP ไลเซนส์ และการตั้งค่าเครือข่ายก่อนจะส่งทราฟฟิกได้ ทั้งเครื่องมือ GUI และบรรทัดคำสั่งใช้ได้ ตัวอย่างในที่นี้ใช้ tmsh ซึ่งเป็นเครื่องมือบรรทัดคำสั่งของ BIG-IP เพราะคำสั่งเหล่านี้บันทึกและทำซ้ำได้
ชื่อเครื่อง DNS และ NTP
ตั้งชื่อเต็มให้เครื่อง เช่น bigip01.example.local ตั้ง DNS server เพื่อให้แปลชื่อได้ และตั้ง NTP เพื่อให้ล็อก ใบรับรอง และข้อความ failover มีเวลาที่ถูกต้อง เปลี่ยนรหัสผ่านแอดมินเริ่มต้นตั้งแต่การล็อกอินแรก และสร้างบัญชีที่มีชื่อให้แต่ละคน
VLAN ผูกกับพอร์ต
VLAN คือส่วนเครือข่ายบน BIG-IP กำหนดแต่ละพอร์ตจริงให้ VLAN โดยมีหรือไม่มีแท็ก VLAN ขึ้นกับสิ่งที่สวิตช์คาดหวัง VLAN ภายนอกหันหน้าสู่ไคลเอนต์ ส่วน VLAN ภายในหันหน้าสู่เซิร์ฟเวอร์ แยกสองเครือข่ายนี้ออกจากกัน เพราะ BIG-IP ทำการกำหนดเส้นทางระหว่างกัน
Self IP
Self IP คือแอดเดรสบน VLAN ที่ BIG-IP ใช้สำหรับทราฟฟิกของตัวเอง เช่น health check และการกำหนดเส้นทาง ให้แต่ละ VLAN มี self IP ในซับเน็ตของมัน ตั้ง allow-service เป็น default เฉพาะในที่ที่จำเป็น และไม่เปิดบริการการจัดการบน VLAN ภายนอกเด็ดขาด
Default route
default route ส่งทราฟฟิกของปลายทางที่ไม่รู้จักไปยัง gateway ตรวจเส้นทางด้วย ping ไปยังไคลเอนต์และเซิร์ฟเวอร์ เซิร์ฟเวอร์ที่เข้าถึง BIG-IP ได้แต่ตอบกลับไม่ได้มักขาดเส้นทางฝั่งเซิร์ฟเวอร์ จึงควรตรวจ default gateway ของเซิร์ฟเวอร์ด้วย
การตั้งค่าอุปกรณ์: ตั้งชื่อเครื่อง DNS NTP VLAN และ self IP
ตั้งชื่อเครื่อง ตั้ง DNS และ NTP นำพอร์ตภายนอกและภายในใส่เข้า VLAN และให้แต่ละ VLAN มี self IP ที่เครื่องใช้สำหรับทราฟฟิกของตัวเอง default route ส่งทราฟฟิกอินเทอร์เน็ตผ่าน gateway ของ ISP บันทึกการตั้งค่า แล้วตรวจ self IP และอินเทอร์เฟซ
# tmsh: hostname, DNS, NTP, VLANs, self IPs and the default route
tmsh modify sys global-settings hostname bigip01.example.local
tmsh modify sys dns name-servers add { 8.8.8.8 }
tmsh modify sys ntp servers add { pool.ntp.org }
tmsh create net vlan external interfaces add { 1.1 }
tmsh create net vlan internal interfaces add { 1.2 { untagged } }
tmsh create net self 203.0.113.5/24 vlan external allow-service default
tmsh create net self 10.10.10.5/24 vlan internal allow-service default
tmsh create net route default network default gw 203.0.113.1
tmsh save sys config
# Check
tmsh list net self
tmsh show net interface
หัวข้อที่ 4: Pool สมาชิก และ health monitor
pool คือกลุ่มเซิร์ฟเวอร์ที่ให้บริการเดียวกัน สมาชิกของ pool คือเซิร์ฟเวอร์กับพอร์ตหนึ่งตัวใน pool health monitor ตรวจสมาชิกแต่ละตัวและทำเครื่องหมายว่าขึ้นหรือลง เพื่อให้ BIG-IP ไม่ส่งคำขอไปยังเซิร์ฟเวอร์ที่ตอบไม่ได้
Pool และสมาชิก
เพิ่มเซิร์ฟเวอร์แต่ละตัวพร้อมพอร์ตเป็นสมาชิก เช่น 10.10.10.11:80 สมาชิกใน pool เดียวกันควรรันแอปพลิเคชันและเนื้อหาเดียวกัน เพราะ BIG-IP ส่งคำขอแต่ละคำขอไปยังสมาชิกตัวใดก็ได้ที่มันเลือก ให้สมาชิกแต่ละตัวมี ratio หรือ priority เมื่อเซิร์ฟเวอร์มีความจุต่างกัน
HTTP monitor
HTTP monitor ส่งคำขอ เช่น GET /health และตรวจว่าคำตอบมีข้อความที่คาดไว้ เช่น 200 OK monitor ที่ตรวจแอปพลิเคชันจริงมีประโยชน์มากกว่า monitor ที่ตรวจเพียงว่าพอร์ตเปิดอยู่ ตั้งช่วงเวลาและ timeout ให้เซิร์ฟเวอร์ที่เสียถูกถอดออกเร็ว แต่ไม่เร็วเกินไปจนการตอบช้าเพียงครั้งเดียวถอดมันออก
สถานะของสมาชิก
สมาชิกอาจอยู่ในสถานะ up, down, disabled หรือ forced offline ค่า disabled ให้การเชื่อมต่อที่มีอยู่ทำงานจนเสร็จ แต่ไม่ส่งการเชื่อมต่อใหม่ ซึ่งมีประโยชน์ก่อนการบำรุงรักษา ส่วน forced offline หยุดทราฟฟิกทั้งหมดทันทีรวมถึงการเชื่อมต่อที่มีอยู่ เลือกสถานะอย่างตั้งใจ เพราะมันเปลี่ยนสิ่งที่ผู้ใช้สัมผัส
การนำเซิร์ฟเวอร์ออกเพื่อบำรุงรักษา
ปิดการใช้งานสมาชิก รอให้การเชื่อมต่อหมดลง ทำการเปลี่ยนแปลง เปิดสมาชิกอีกครั้ง แล้วตรวจว่า monitor ทำเครื่องหมายว่าขึ้น การทำทีละเซิร์ฟเวอร์ทำให้บริการยังทำงานอยู่
การตั้งค่าอุปกรณ์: สร้าง health monitor และ pool
monitor ส่งคำขอไปยังเซิร์ฟเวอร์แต่ละตัวและทำเครื่องหมายว่าใช้งานได้เฉพาะเมื่อคำตอบตรงตามที่กำหนด pool รวมเซิร์ฟเวอร์เข้าด้วยกัน ใช้ monitor กับสมาชิกแต่ละตัว และเลือกวิธีกระจายโหลด เซิร์ฟเวอร์ที่ monitor ล้มเหลวจะถูกถอดออกจากการหมุนเวียนโดยอัตโนมัติ
# tmsh: a health monitor and a pool with two web servers
tmsh create ltm monitor http web_mon defaults-from http send "GET /health HTTP/1.0\r\n\r\n" recv "200 OK"
tmsh create ltm pool web_pool members add { 10.10.10.11:80 10.10.10.12:80 } monitor web_mon load-balancing-mode round-robin
tmsh save sys config
# Check
tmsh show ltm pool web_pool members
tmsh list ltm monitor http web_mon
หัวข้อที่ 5: Virtual server, SNAT และโปรไฟล์
virtual server คือแอดเดรสและพอร์ตที่ไคลเอนต์เชื่อมต่อ มันคือประตูหน้าของบริการ มีแอดเดรสปลายทาง พอร์ต โปรโตคอล pool โปรไฟล์ที่ควบคุมวิธีจัดการทราฟฟิก และวิธีแปลแอดเดรสต้นทาง
ปลายทาง โปรโตคอล และ pool
virtual server ของบริการเว็บอาจเป็น 203.0.113.10:443 ด้วย TCP ที่ส่งทราฟฟิกไปยัง web_pool ไคลเอนต์ใช้เพียงแอดเดรสนี้ pool และสมาชิกถูกซ่อนอยู่ด้านหลัง ทีมจึงเปลี่ยนเซิร์ฟเวอร์ได้โดยไม่ต้องเปลี่ยนแอดเดรสที่ผู้ใช้รู้จัก
โปรไฟล์
โปรไฟล์ควบคุมวิธีประมวลผลทราฟฟิก โปรไฟล์ TCP ปรับแต่งการเชื่อมต่อ โปรไฟล์ HTTP อ่านคำขอเพื่อให้ LTM ตัดสินใจตาม URL หรือ header และโปรไฟล์ SSL ฝั่งไคลเอนต์ยุติการเข้ารหัส ใช้เฉพาะโปรไฟล์ที่บริการต้องการ เพราะแต่ละโปรไฟล์เพิ่มการประมวลผล
SNAT automap
หากไม่มีการแปลแอดเดรสต้นทาง เซิร์ฟเวอร์จะเห็นแอดเดรสของไคลเอนต์และตอบกลับตรงไปยังไคลเอนต์ โดยข้าม BIG-IP ทำให้การเชื่อมต่อขาด SNAT automap เขียนต้นทางใหม่เป็น self IP บน VLAN ภายใน เพื่อให้เซิร์ฟเวอร์ตอบผ่าน BIG-IP ตรวจการเชื่อมต่อด้วย show ltm connection เพื่อยืนยันเส้นทาง
ทดสอบ virtual server
ทดสอบจากไคลเอนต์จริง ไม่ใช่จาก BIG-IP เพียงอย่างเดียว ตรวจสถานะ virtual server แล้วดู pool และสมาชิก หาก virtual server พร้อมใช้งานแต่ผู้ใช้ยังเจอข้อผิดพลาด ปัญหามักอยู่ที่โปรไฟล์ ใบรับรอง หรือแอปพลิเคชันบนเซิร์ฟเวอร์
การตั้งค่าอุปกรณ์: เผยแพร่ pool ด้วย virtual server
virtual server คือแอดเดรสที่ไคลเอนต์เชื่อมต่อ มันส่งทราฟฟิกไปยัง pool ใช้โปรไฟล์ (TCP, HTTP และ SSL ฝั่งไคลเอนต์) และใช้ SNAT automap เพื่อให้เซิร์ฟเวอร์ตอบผ่าน BIG-IP ตรวจการเชื่อมต่อด้วย show ltm connection
# tmsh: a virtual server that publishes the pool on 203.0.113.10:443
tmsh create ltm virtual vs_web destination 203.0.113.10:443 ip-protocol tcp pool web_pool profiles add { tcp http clientssl } source-address-translation { type automap }
tmsh save sys config
# Check
tmsh list ltm virtual vs_web
tmsh show ltm virtual vs_web
tmsh show ltm connection
หัวข้อที่ 6: วิธีกระจายโหลดและ persistence
วิธีกระจายโหลดตัดสินว่าสมาชิกตัวใดจะได้การเชื่อมต่อใหม่แต่ละครั้ง persistence ตัดสินว่าเมื่อใดไคลเอนต์ควรกลับมาที่สมาชิกตัวเดิม เช่น เมื่อเซิร์ฟเวอร์เก็บเซสชันการล็อกอินของผู้ใช้ไว้ในหน่วยความจำของตัวเอง
Round robin และ ratio
round robin ให้การเชื่อมต่อแก่สมาชิกแต่ละตัวทีละตัวตามลำดับ ทำงานได้ดีเมื่อเซิร์ฟเวอร์เหมือนกันและคำขอคล้ายกัน วิธี ratio ให้เซิร์ฟเวอร์ที่แรงกว่ามีส่วนแบ่งมากกว่า ตั้งวิธีไว้ที่ pool และทดสอบการเปลี่ยนแปลงกับไคลเอนต์ไม่กี่เครื่องก่อนนำไปใช้กับผู้ใช้ทั้งหมด
Least connections และ fastest
least connections ส่งคำขอใหม่ไปยังสมาชิกที่มีการเชื่อมต่อที่ใช้งานอยู่น้อยที่สุด เหมาะกับคำขอที่ใช้เวลาต่างกันมาก fastest ส่งคำขอไปยังสมาชิกที่ตอบเร็วที่สุดในช่วงหลัง เลือกวิธีที่ตรงกับงานที่เซิร์ฟเวอร์ทำ ไม่ใช่วิธีที่มีตัวเลือกมากที่สุด
Persistence
persistence ทำให้ไคลเอนต์อยู่กับสมาชิกตัวเดิมชั่วระยะหนึ่ง cookie persistence ใส่ค่าที่ระบุสมาชิกลงในเบราว์เซอร์ และเป็นตัวเลือกทั่วไปสำหรับเว็บแอปพลิเคชัน persistence ตามแอดเดรสต้นทางใช้ IP ของไคลเอนต์ และอ่อนกว่า เพราะผู้ใช้จำนวนมากที่อยู่หลังแอดเดรสเดียวกันจะไปลงที่เซิร์ฟเวอร์เดียวกันทั้งหมด
เมื่อ persistence ก่อปัญหา
ระเบียน persistence ที่ชี้ไปยังสมาชิกที่ล่มไปแล้วอาจทำให้เซสชันของผู้ใช้ขาดจนกว่าระเบียนจะหมดอายุ ควรตั้ง timeout ของ persistence ให้สั้นเท่าที่ทำได้ และทำให้แอปพลิเคชันกู้คืนจากเซสชันที่หายได้
หัวข้อที่ 7: การถ่ายโอน SSL และใบรับรอง
การเข้ารหัสและถอดรหัส TLS กินเวลาประมวลผลของเซิร์ฟเวอร์ทุกเครื่อง SSL offload ย้ายงานนี้ไปที่ BIG-IP มันเก็บใบรับรอง ถอดรหัสทราฟฟิกของไคลเอนต์ และส่ง HTTP ธรรมดาไปยังเซิร์ฟเวอร์ผ่านเครือข่ายภายใน ซึ่งได้รับการคุ้มครองจากการออกแบบเครือข่าย
การถ่ายโอนทำงานอย่างไร
โปรไฟล์ SSL ฝั่งไคลเอนต์เก็บใบรับรองและคีย์ส่วนตัว เซสชัน TLS ของไคลเอนต์สิ้นสุดที่ BIG-IP ซึ่งอ่านคำขอและส่งต่อไปยังสมาชิกที่พอร์ต 80 เซิร์ฟเวอร์จึงไม่ต้องมีใบรับรองสำหรับชื่อสาธารณะ ทำให้การต่ออายุง่ายขึ้น
ใบรับรองและคีย์
เก็บคีย์ส่วนตัวไว้ที่ BIG-IP เท่านั้น และป้องกันการเข้าถึงการจัดการที่สามารถส่งออกคีย์ได้ วางแผนการต่ออายุใบรับรองล่วงหน้า เพราะใบรับรองที่หมดอายุทำให้บริการหยุดสำหรับผู้ใช้ทุกคน ใช้ใบรับรองที่ตรงกับชื่อสาธารณะของแอดเดรส virtual server
การเข้ารหัสซ้ำและเมื่อใดควรใช้
หากทราฟฟิกต้องถูกเข้ารหัสต่อบนเครือข่ายภายใน BIG-IP สามารถเปิดเซสชัน TLS ใหม่ไปยังเซิร์ฟเวอร์ด้วยโปรไฟล์ SSL ฝั่งเซิร์ฟเวอร์ วิธีนี้ใช้การประมวลผลมากขึ้นแต่ปกป้องทราฟฟิกภายในศูนย์ข้อมูล เลือกใช้เมื่อเครือข่ายภายในไม่น่าเชื่อถือ
หัวข้อที่ 8: High Availability และ sync-failover
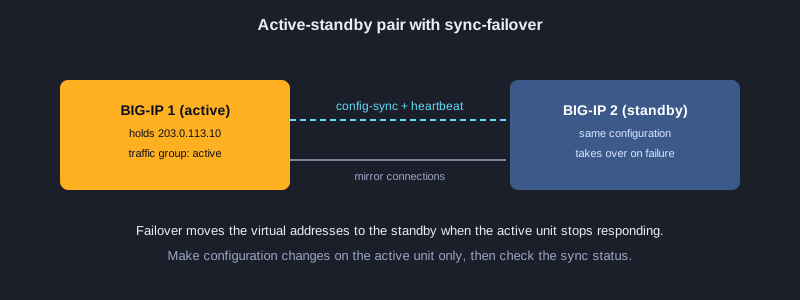
BIG-IP สองเครื่องทำงานเป็นคู่ active-standby ได้ เครื่องสแตนด์บายมีการตั้งค่าเดียวกันและรับแอดเดรสของ virtual server เมื่อเครื่องที่ใช้งานอยู่เสีย ไคลเอนต์มักเห็นการขัดข้องสั้น ๆ ไม่ใช่การล่ม หากตั้ง failover ถูกต้อง
device group และ config-sync
device group แบบ sync-failover ระบุเครื่องที่แชร์การตั้งค่า config-sync คัดลอกการเปลี่ยนแปลงจากเครื่องหนึ่งไปยังอีกเครื่องผ่านเครือข่ายเฉพาะ ทำการเปลี่ยนแปลงบนเครื่องที่ใช้งานอยู่เท่านั้น และตรวจสถานะการซิงก์หลังจากนั้น เพราะการเปลี่ยนแปลงบนเครื่องสแตนด์บายจะถูกเขียนทับโดยการซิงก์ครั้งถัดไป
สิ่งที่ทำให้เกิด failover
เครื่องสแตนด์บายรับงานเมื่อเครื่องที่ใช้งานอยู่สูญเสีย heartbeat เมื่อ traffic group ที่ถูกติดตามล้มเหลว หรือเมื่อผู้ดูแลสั่ง failover ทดสอบแต่ละตัวกระตุ้นในช่วงเวลาที่วางแผนไว้ และยืนยันว่าแอดเดรสใดย้ายไป และเซสชันยังอยู่
ทดสอบ failover โดยไม่ให้บริการล่ม
รัน failover ที่วางแผนไว้ในช่วงที่มีทราฟฟิกน้อย ดูการเชื่อมต่อและ traffic group และถอยกลับหากผลไม่เป็นอย่างที่คาด failover ที่ไม่เคยทดสอบคือความเสี่ยง ไม่ใช่การป้องกัน
การตั้งค่าอุปกรณ์: ตั้ง sync-failover แบบ active-standby
ทั้งสองเครื่องแชร์การตั้งค่าผ่าน config-sync address และ mirror address บนเครือข่ายเฉพาะ device group ทำให้การตั้งค่าตรงกัน และ failover ย้ายทราฟฟิกไปยังเครื่องสแตนด์บายเมื่อเครื่องที่ใช้งานอยู่เสีย ทดสอบ failover ในช่วงเวลาที่วางแผนไว้
# tmsh: a sync-failover device group for an active-standby pair (run on the primary unit)
tmsh modify cm device bigip01.example.local configsync-ip 10.10.20.5 unicast-address { { ip 10.10.20.5 } } mirror-ip 10.10.20.5
tmsh create cm device-group failover-group type sync-failover devices add { bigip01.example.local bigip02.example.local } auto-sync enabled
tmsh run cm config-sync to-group failover-group
# Check
tmsh show cm sync-status
tmsh show sys failover
หัวข้อที่ 9: การแก้ปัญหาและการเฝ้าดู
เมื่อมีบางอย่างเสีย ให้ไล่ตามเส้นทางของข้อมูลตามลำดับ: ไคลเอนต์ virtual server โปรไฟล์ pool สมาชิก และเซิร์ฟเวอร์ แต่ละขั้นมีคำสั่งหรือล็อกที่แสดงว่าคำขอไปถึงขั้นนั้นหรือไม่
เริ่มจากสมาชิกของ pool
แสดงสมาชิกของ pool เพื่อดูว่าเซิร์ฟเวอร์ตัวใดล่ม แล้วอ่านผลของ monitor สมาชิกที่ monitor ทำเครื่องหมายว่าล่มมักหมายความว่า health check ล้มเหลว ไม่ใช่ว่าทราฟฟิกของผู้ใช้ผิด ตรวจแอปพลิเคชันบนเซิร์ฟเวอร์ก่อนจะโทษ load balancer
อ่านล็อก
LTM log บันทึกการเปลี่ยนแปลงของ monitor การเปลี่ยนสถานะของ virtual server และข้อผิดพลาดในการตั้งค่า อ่านหลังทุกความล้มเหลว ล็อกแสดงเวลาของแต่ละเหตุการณ์ ซึ่งช่วยจับคู่รายงานของผู้ใช้กับการเปลี่ยนแปลงหรือการล่มของเซิร์ฟเวอร์
จับการจราจร
การจับแพ็กเก็ตบน BIG-IP หรือบนเซิร์ฟเวอร์แสดงว่าคำขอมาถึงหรือไม่ เซิร์ฟเวอร์ตอบอะไร และการเชื่อมต่อหยุดที่ไหน จับเท่าที่จำเป็น และกรองตามโฮสต์และพอร์ต เพราะการจับทั้งหมดบนเครื่องที่งานหนักจะทำให้เครื่องช้าลง
บันทึกและจดการแก้ไข
หลังการแก้ไข บันทึกการตั้งค่า และจดว่าอะไรเสีย อะไรเปลี่ยน และยืนยันอย่างไร บันทึกนี้ทำให้การสืบสวนครั้งหน้าสั้นลง และแสดงให้ทีมเห็นว่าการเปลี่ยนแปลงได้รับการตรวจสอบแล้ว
การตั้งค่าอุปกรณ์: ตรวจสมาชิก pool และแก้ปัญหาเซิร์ฟเวอร์ที่ล้มเหลว
เมื่อผู้ใช้รายงานข้อผิดพลาด ให้แสดงสมาชิกของ pool เพื่อดูว่าเซิร์ฟเวอร์ตัวใดล้มเหลว แล้วอ่าน LTM log เพื่อดูผลของ monitor การจับแพ็กเก็ตฝั่งเซิร์ฟเวอร์แสดงว่าคำขอไปถึงเซิร์ฟเวอร์หรือไม่ และเซิร์ฟเวอร์ตอบอะไร แก้ที่เซิร์ฟเวอร์หรือ monitor แล้วตรวจอีกครั้งก่อนปิดเคส
# tmsh: check a pool member that is down, then look at the logs and capture the traffic
tmsh show ltm pool web_pool members
tmsh show ltm pool web_pool members detail
tmsh show sys hardware
tail -n 50 /var/log/ltm
tcpdump -ni 0.0:nnn -s0 host 10.10.10.11 and port 80
ฝึกในแล็บ
ทักษะ load balancer มาจากการลงมือทำ จึงควรสร้างแล็บเล็ก ๆ ที่มีสามส่วน: ไคลเอนต์ BIG-IP ตรงกลาง และเว็บเซิร์ฟเวอร์สองตัวบนเครือข่ายภายใน ใช้ BIG-IP virtual edition หรือเครื่องแล็บ และทำตามขั้นตอนนี้ตามลำดับ
1. วาดแนวคิดและเขียนแผนแอดเดรสสำหรับเครือข่ายภายนอกและภายใน
2. ตั้งชื่อเครื่อง DNS และ NTP และสร้างบัญชีแอดมินที่มีชื่อ
3. สร้าง VLAN ภายนอกและภายใน เพิ่ม self IP ให้แต่ละตัว และเพิ่ม default route
4. ตรวจการเชื่อมต่อจากไคลเอนต์ไปยัง self IP ภายนอก และจาก BIG-IP ไปยังเว็บเซิร์ฟเวอร์แต่ละตัว
5. สร้าง HTTP health monitor และ pool ที่มีเว็บเซิร์ฟเวอร์สองตัว
6. สร้าง virtual server บนแอดเดรสภายนอกพร้อม SNAT automap แล้วทดสอบจากไคลเอนต์
7. หยุดเว็บเซิร์ฟเวอร์ตัวหนึ่ง ดู monitor ทำเครื่องหมายว่าล่ม แล้วเริ่มใหม่และยืนยันว่ากลับเข้า pool
8. บันทึกการตั้งค่า เปลี่ยนหนึ่งจุด แล้วกู้คืนเวอร์ชันที่บันทึกไว้เพื่อยืนยันว่าการย้อนกลับทำงาน
ขั้นต่อไป
หลังพื้นฐาน ฝึกการออกแบบ monitor และ pool สำหรับแอปพลิเคชันจริง จากนั้นศึกษาโปรไฟล์ SSL และการต่ออายุใบรับรอง แล้วทดสอบ High Availability บันทึกทุกการเปลี่ยนแปลงกับ virtual server และ pool การล่มส่วนใหญ่มาจากการเปลี่ยนแปลงที่ไม่มีใครจด ไม่ใช่จากการตั้งค่าผิดค่าเดียว
สรุป
BIG-IP LTM กระจายคำขอของไคลเอนต์ไปยัง pool ของเซิร์ฟเวอร์ที่พร้อมใช้งานหลังแอดเดรส virtual server เดียว การตั้งค่าที่ดีเริ่มจากแผนภาพแนวคิดและแผนแอดเดรส แล้วชื่อเครื่อง VLAN self IP และ default route จากนั้นคือ pool พร้อม health monitor จริง virtual server ที่มี SNAT วิธีกระจายโหลดที่เหมาะกับงาน และเลือกได้ว่าจะถ่ายโอน SSL และตั้งคู่ active-standby หรือไม่ บันทึกการตั้งค่าก่อนทุกการเปลี่ยนแปลง และแก้ปัญหาตามลำดับของเส้นทางข้อมูล