Balanceamento de Carga F5 BIG-IP LTM: Conceitos de Configuração, de VLANs ao Failover

O F5 BIG-IP Local Traffic Manager (LTM) fica na frente de um grupo de servidores e distribui as requisições dos clientes entre eles. Ele verifica quais servidores estão saudáveis, mantém requisições relacionadas no mesmo servidor quando necessário, descarrega a criptografia TLS e assume automaticamente quando a segunda unidade está em standby. Este artigo cobre a configuração completa na ordem em que você vai encontrá-la: o que o LTM faz, planejamento do projeto, primeiro acesso e rede, pools e monitores de saúde, virtual servers, métodos de balanceamento e persistência, descarregamento SSL, alta disponibilidade e solução de problemas. Os exemplos de configuração mostram os comandos tmsh em cada passo.
O que você precisa
Você deve entender endereçamento IP, sub-redes, VLANs e as funções de roteador e switch. Ajuda ter lido o artigo de CCNA e as ideias de balanceamento de carga do artigo de FortiGate deste site. Para praticar, use uma unidade de laboratório BIG-IP ou a edição virtual oferecida pelo fabricante. Trabalhe apenas em unidades que você possui ou está autorizado a configurar, e nunca altere um balanceador de carga de produção sem um plano por escrito e um caminho de reversão.
Ilustração
Tópico 1: O que o BIG-IP LTM faz
Um balanceador de carga faz um grupo de servidores parecer um único serviço. O cliente se conecta a um endereço, e o LTM decide qual servidor atende cada requisição. Isso oferece mais capacidade, permite retirar servidores para manutenção sem interromper o serviço e esconde falhas de servidores dos usuários. O LTM trabalha nas camadas de transporte e de aplicação, então suas decisões podem usar detalhes do TCP e do conteúdo HTTP.
Por que usar um balanceador de carga
Um único servidor web tem um limite de usuários que consegue atender. Adicionar servidores só ajuda se alguém distribuir as requisições entre eles. O LTM divide a carga, verifica cada servidor e deixa de enviar tráfego para um servidor que caiu. O usuário vê apenas um endereço, e a equipe pode trocar servidores sem alterar esse endereço.
Gerenciamento de tráfego local e outros produtos F5
O LTM balanceia o tráfego dentro de um data center. O Global Traffic Manager (GTM, hoje balanceamento baseado em DNS) escolhe entre data centers. O Application Security Manager (ASM, hoje Advanced WAF) acrescenta recursos de firewall de aplicação web. Estude o LTM primeiro, porque os mesmos objetos, como pools e virtual servers, são usados pelos outros produtos.
Caminho dos dados
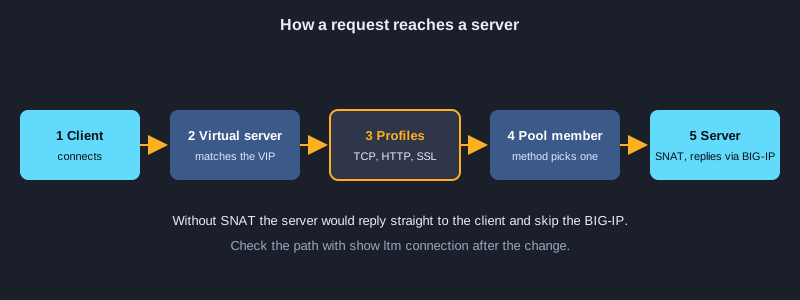
A requisição chega ao endereço do virtual server, passa pelos perfis, é associada a um pool e é enviada a um membro. A resposta do membro volta pelo BIG-IP, por isso o BIG-IP precisa estar no caminho entre o cliente e o servidor, ou tratar o tráfego de resposta com SNAT.
Tópico 2: Planejando o projeto antes de configurar
A maioria das falhas de balanceador de carga vem de um projeto que nunca foi escrito, não do equipamento. Antes de abrir a ferramenta de configuração, planeje a rede, os servidores, as verificações de saúde e o failover.
Desenhe o conceito
Desenhe o cliente, a rede externa, o BIG-IP, a rede interna com os servidores web e a unidade de standby. Identifique cada porta com sua VLAN, e cada endereço com sua finalidade: endereço do virtual server, self IP, endereço dos servidores e endereço de gerenciamento. Esse desenho é a referência para todos os passos seguintes.
Escreva o plano de endereços
Anote o endereço do virtual server que os usuários acessam, o self IP de cada VLAN, os endereços dos servidores, o gateway padrão e o endereço de gerenciamento. Separe a rede de gerenciamento da rede de tráfego. Mudar um endereço depois será fácil se todos os objetos que dependem dele estiverem listados.
Defina como verificar os servidores
Defina o que significa um servidor saudável para cada serviço. Um servidor web pode ser verificado com uma requisição HTTP a uma página de saúde, e um banco de dados com uma conexão TCP. Uma verificação que testa apenas a porta pode marcar como saudável uma aplicação quebrada, então teste aquilo de que o usuário realmente precisa.
Planeje a reversão
Salve a configuração antes da primeira alteração, e anote como restaurá-la. Planeje uma janela de manutenção para qualquer mudança que mova tráfego ativo, e avise as pessoas que dependem do serviço.
Tópico 3: Primeiro acesso, VLANs, self IP e roteamento
Um BIG-IP novo precisa de nome de host, DNS, NTP, licença e rede antes de conseguir transportar tráfego. Tanto a ferramenta de configuração quanto a linha de comando podem ser usadas. Os exemplos aqui usam o tmsh, a ferramenta de linha de comando do BIG-IP, porque os mesmos comandos podem ser salvos e repetidos.
Nome de host, DNS e NTP
Dê à unidade um nome completo, como bigip01.example.local. Configure servidores DNS para que os nomes possam ser resolvidos, e NTP para que logs, certificados e mensagens de failover tenham horário correto. Troque a senha padrão do administrador no primeiro login e crie uma conta nominal para cada pessoa.
VLANs mapeadas às portas
Uma VLAN é um segmento de rede dentro do BIG-IP. Atribua cada porta física a uma VLAN, com ou sem tag, dependendo do que o switch espera. A VLAN externa fica voltada para os clientes e a VLAN interna para os servidores. Mantenha as duas redes separadas, porque o BIG-IP faz o roteamento entre elas.
Self IP
Um self IP é um endereço em uma VLAN que o BIG-IP usa para seu próprio tráfego, como verificações de saúde e roteamento. Dê a cada VLAN um self IP dentro da sub-rede dela. Configure o allow-service como padrão apenas quando necessário, e nunca permita serviços de gerenciamento na VLAN externa.
Rota padrão
A rota padrão envia o tráfego para destinos desconhecidos ao gateway. Verifique as rotas com ping para os clientes e para os servidores. Um servidor que alcança o BIG-IP mas não consegue responder geralmente não tem rota de volta do lado do servidor, então verifique também o gateway padrão do servidor.
Configuração do equipamento: nome de host, DNS, NTP, VLANs e self IP
Dê nome à unidade, configure DNS e NTP, coloque as portas externa e interna em suas VLANs e atribua a cada VLAN um self IP que a unidade usa para seu próprio tráfego. A rota padrão envia o tráfego da internet pelo gateway do provedor. Salve a configuração e depois confira os self IPs e as interfaces.
# tmsh: nome de host, DNS, NTP, VLANs, self IP e rota padrão
tmsh modify sys global-settings hostname bigip01.example.local
tmsh modify sys dns name-servers add { 8.8.8.8 }
tmsh modify sys ntp servers add { pool.ntp.org }
tmsh create net vlan external interfaces add { 1.1 }
tmsh create net vlan internal interfaces add { 1.2 { untagged } }
tmsh create net self 203.0.113.5/24 vlan external allow-service default
tmsh create net self 10.10.10.5/24 vlan internal allow-service default
tmsh create net route default network default gw 203.0.113.1
tmsh save sys config
# Verificar
tmsh list net self
tmsh show net interface
Tópico 4: Pools, membros e monitores de saúde
Um pool é um grupo de servidores que oferecem o mesmo serviço. Um membro do pool é um servidor e uma porta dentro do pool. Um monitor de saúde verifica cada membro e o marca como ativo ou inativo, para que o BIG-IP nunca envie requisições a um servidor que não consegue responder.
Pool e membros
Adicione cada servidor e sua porta como membro, por exemplo 10.10.10.11:80. Os membros de um mesmo pool devem executar a mesma aplicação e o mesmo conteúdo, porque o BIG-IP envia cada requisição a qualquer membro que escolher. Dê a cada membro uma proporção ou prioridade quando a capacidade dos servidores for diferente.
Monitor HTTP
Um monitor HTTP envia uma requisição, como GET /health, e verifica se a resposta contém o texto esperado, como 200 OK. Um monitor que testa a aplicação real é muito mais útil do que um que só verifica se a porta está aberta. Ajuste o intervalo e o timeout para que um servidor com falha seja retirado rapidamente, mas não tão rapidamente que uma única resposta lenta já o derrube.
Status dos membros
Um membro pode estar ativo, inativo, desabilitado ou forçado offline. Desabilitado deixa as conexões existentes terminarem, mas não envia novas conexões, o que é útil antes de uma manutenção. Forçado offline interrompe todo o tráfego de uma vez, incluindo as conexões existentes. Escolha o status com cuidado, porque ele muda o que o usuário percebe.
Retirando um servidor para manutenção
Desabilite o membro, espere as conexões terminarem, faça a alteração, reative o membro e confirme que o monitor o marcou como ativo. Fazer isso um servidor por vez mantém o serviço funcionando.
Configuração do equipamento: criar o monitor de saúde e o pool
O monitor envia uma requisição a cada servidor e só o marca como ativo quando a resposta coincide. O pool agrupa os servidores, aplica o monitor a cada membro e escolhe o método de distribuição de carga. Um membro que falha no monitor é retirado da rotação automaticamente.
# tmsh: monitor de saúde e pool com dois servidores web
tmsh create ltm monitor http web_mon defaults-from http send "GET /health HTTP/1.0\r\n\r\n" recv "200 OK"
tmsh create ltm pool web_pool members add { 10.10.10.11:80 10.10.10.12:80 } monitor web_mon load-balancing-mode round-robin
tmsh save sys config
# Verificar
tmsh show ltm pool web_pool members
tmsh list ltm monitor http web_mon
Tópico 5: Virtual servers, SNAT e perfis
Um virtual server é o endereço e a porta a que o cliente se conecta. É a porta de entrada do serviço. Ele tem um endereço e uma porta de destino, um protocolo, um pool, perfis que definem como o tráfego é tratado e a forma de traduzir o endereço de origem.
Destino, protocolo e pool
Um virtual server para um serviço web pode ser 203.0.113.10:443 com TCP, enviando o tráfego ao web_pool. O cliente conhece apenas esse endereço. O pool e seus membros ficam escondidos atrás dele, então a equipe pode trocar servidores sem alterar o endereço que os usuários conhecem.
Perfis
Os perfis definem como o tráfego é processado. O perfil TCP ajusta a conexão, o perfil HTTP lê as requisições para que o LTM possa decidir com base na URL ou nos cabeçalhos, e o perfil SSL do lado do cliente encerra a criptografia. Use apenas os perfis de que o serviço precisa, porque cada perfil acrescenta processamento.
SNAT automap
Sem tradução de origem, o servidor vê o endereço do cliente e responde diretamente a ele, contornando o BIG-IP, e a conexão falha. O SNAT automap reescreve a origem para um self IP na VLAN interna, para que o servidor responda pelo BIG-IP. Confirme o caminho com show ltm connection.
Testando o virtual server
Teste a partir de um cliente real, e não apenas a partir do BIG-IP. Confira o status do virtual server e depois o pool e seus membros. Se o virtual server estiver disponível, mas o usuário receber erro, o problema geralmente está no perfil, no certificado ou na aplicação do servidor.
Configuração do equipamento: publicar o pool com um virtual server
O virtual server é o endereço que o cliente acessa. Ele envia o tráfego ao pool, aplica os perfis (TCP, HTTP e SSL do lado do cliente) e usa o SNAT automap para que o servidor responda pelo BIG-IP. Confira a conexão com show ltm connection.
# tmsh: virtual server que publica o pool em 203.0.113.10:443
tmsh create ltm virtual vs_web destination 203.0.113.10:443 ip-protocol tcp pool web_pool profiles add { tcp http clientssl } source-address-translation { type automap }
tmsh save sys config
# Verificar
tmsh list ltm virtual vs_web
tmsh show ltm virtual vs_web
tmsh show ltm connection
Tópico 6: Métodos de balanceamento e persistência
O método de balanceamento decide qual membro recebe cada nova conexão. A persistência decide quando um cliente deve continuar voltando ao mesmo membro, por exemplo quando o servidor guarda o login do usuário na própria memória.
Round robin e proporção
O round robin dá a cada membro uma conexão, em sequência. Funciona bem quando todos os servidores são iguais e as requisições são parecidas. O método de proporção dá uma fatia maior aos servidores mais potentes. O método é definido no pool, e você pode testar a mudança com alguns clientes antes de aplicá-la a todos os usuários.
Menos conexões e mais rápido
O método de menos conexões envia cada nova requisição ao membro com menos conexões ativas. É adequado para requisições que levam tempos muito diferentes. O método mais rápido envia a requisição ao membro que respondeu mais depressa recentemente. Escolha o método de acordo com o trabalho dos servidores, e não pela quantidade de opções disponíveis.
Persistência
A persistência mantém um cliente no mesmo membro por um período. A persistência por cookie insere um valor no navegador que identifica o membro, e é a escolha usual para aplicações web. A persistência por endereço de origem usa o IP do cliente e é mais fraca, porque muitos usuários atrás de um mesmo endereço vão todos para o mesmo servidor.
Quando a persistência causa problemas
Um registro de persistência que aponta para um membro que já caiu pode derrubar a sessão do usuário até que o registro expire. Mantenha o timeout da persistência curto quando possível, e faça a aplicação se recuperar de sessões perdidas.
Tópico 7: Descarregamento SSL e certificados
Criptografar e descriptografar TLS consome processamento em cada servidor. O descarregamento SSL transfere esse trabalho para o BIG-IP. O BIG-IP guarda os certificados, descriptografa o tráfego do cliente e envia HTTP simples aos servidores pela rede interna, que é protegida pelo projeto da rede.
Como o descarregamento funciona
Um perfil SSL do lado do cliente guarda o certificado e a chave privada. A sessão TLS do cliente termina no BIG-IP, que lê a requisição e a encaminha a um membro na porta 80. Os servidores então não precisam de certificado para o nome público, o que simplifica a renovação dos certificados.
Certificados e chaves
Guarde a chave privada apenas no BIG-IP, e proteja o acesso de gerenciamento que poderia exportá-la. Planeje a renovação dos certificados com antecedência, porque um certificado expirado interrompe o serviço para todos os usuários. Use um certificado que corresponda ao nome público no endereço do virtual server.
Recriptografia e quando usá-la
Se o tráfego precisar continuar criptografado dentro da rede interna, o BIG-IP pode abrir uma nova sessão TLS com o servidor usando um perfil SSL do lado do servidor. Isso exige mais processamento, mas protege o tráfego dentro do data center. Escolha essa opção quando a rede interna não for confiável.
Tópico 8: Alta disponibilidade e sync-failover
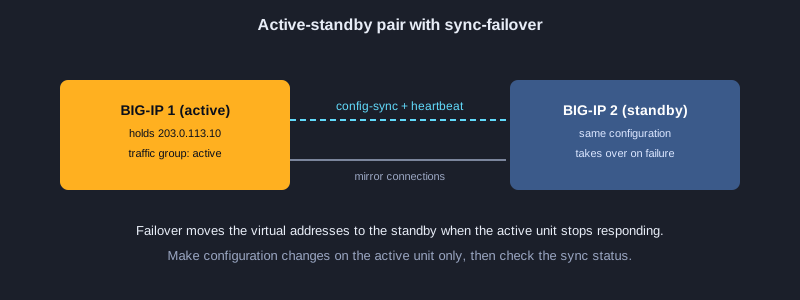
Duas unidades BIG-IP podem operar como um par ativo-standby. A unidade de standby tem a mesma configuração e assume os endereços virtuais quando a unidade ativa falha. Os clientes normalmente percebem apenas uma pequena interrupção, e não uma queda total, se o failover estiver configurado corretamente.
Device group e config-sync
Um device group de sync-failover lista as unidades que compartilham a configuração. O config-sync copia as mudanças de uma unidade para a outra por uma rede dedicada. Faça as alterações somente na unidade ativa e verifique o estado da sincronização depois, porque mudanças feitas na unidade de standby serão sobrescritas pela próxima sincronização.
Gatilhos de failover
A unidade de standby assume quando a unidade ativa perde o heartbeat, quando um traffic group monitorado falha, ou quando o administrador força o failover. Teste cada gatilho em uma janela planejada, e confirme quais endereços se movem e se as sessões são preservadas.
Testando o failover sem interrupção
Execute um failover planejado em um horário de pouco uso, acompanhe as conexões e os traffic groups, e faça o failback se o resultado não for o esperado. Um failover nunca testado é um risco, não uma proteção.
Configuração do equipamento: configurar sync-failover ativo-standby
As duas unidades compartilham a configuração pelos endereços de config-sync e de espelhamento em uma rede dedicada. O device group mantém a configuração alinhada, e o failover move o tráfego para a unidade de standby quando a unidade ativa falha. Teste o failover em uma janela planejada.
# tmsh: device group de sync-failover para o par ativo-standby (execute na unidade principal)
tmsh modify cm device bigip01.example.local configsync-ip 10.10.20.5 unicast-address { { ip 10.10.20.5 } } mirror-ip 10.10.20.5
tmsh create cm device-group failover-group type sync-failover devices add { bigip01.example.local bigip02.example.local } auto-sync enabled
tmsh run cm config-sync to-group failover-group
# Verificar
tmsh show cm sync-status
tmsh show sys failover
Tópico 9: Solução de problemas e monitoramento
Quando algo quebra, percorra o caminho dos dados em ordem: cliente, virtual server, perfis, pool, membro e depois o servidor. Cada etapa tem um comando ou um log que mostra se a requisição chegou até ali.
Comece pelos membros do pool
Mostre os membros do pool para ver quais servidores estão inativos, e leia o resultado dos monitores. Um membro marcado como inativo pelo monitor geralmente significa que a verificação de saúde falhou, e não que houve um problema no tráfego do usuário. Verifique a aplicação no servidor antes de culpar o balanceador de carga.
Leia os logs
Os logs do LTM registram mudanças de monitor, mudanças de status de virtual server e erros de configuração. Leia os logs após cada falha. Eles mostram o horário de cada evento, o que ajuda a relacionar o relato do usuário com uma mudança ou com a queda de um servidor.
Capture o tráfego
Uma captura de pacotes no BIG-IP ou no servidor mostra se a requisição chegou, o que o servidor respondeu e onde a conexão parou. Capture apenas o tempo necessário e filtre por host e porta, porque uma captura completa em uma unidade ocupada a deixa mais lenta.
Registre a correção
Depois de uma correção, salve a configuração e escreva o que falhou, o que foi alterado e como você confirmou. Essa anotação encurta a próxima investigação e mostra à equipe que a mudança foi verificada.
Configuração do equipamento: verificar membros e corrigir servidores com falha
Quando o usuário relatar um erro, mostre os membros do pool para ver qual servidor está inativo, depois leia o log do LTM para ver o resultado dos monitores. Uma captura de pacotes do lado do servidor mostra se a requisição chega e o que ele responde. Corrija o servidor ou o monitor, e verifique de novo antes de encerrar o caso.
# tmsh: verificar membros inativos, depois ver o log e capturar o tráfego
tmsh show ltm pool web_pool members
tmsh show ltm pool web_pool members detail
tmsh show sys hardware
tail -n 50 /var/log/ltm
tcpdump -ni 0.0:nnn -s0 host 10.10.10.11 and port 80
Prática em laboratório
A habilidade com balanceador de carga vem da prática, então monte um pequeno laboratório com três redes: o cliente, o BIG-IP no meio e dois servidores web na rede interna. Use o BIG-IP em edição virtual ou uma unidade de laboratório, e siga estes passos em ordem.
1. Desenhe o conceito e escreva o plano de endereços para as redes externa e interna.
2. Configure nome de host, DNS e NTP, e crie uma conta de administrador nominal.
3. Crie as VLANs externa e interna, adicione um self IP a cada uma e depois adicione a rota padrão.
4. Confirme a conectividade do cliente com o self IP externo, e do BIG-IP com cada servidor web.
5. Crie um monitor HTTP e um pool com os dois servidores web.
6. Crie um virtual server no endereço externo com SNAT automap, depois teste a partir do cliente.
7. Desligue um dos servidores web, confirme que o monitor o marca como inativo, depois ligue-o novamente e confirme que ele volta ao pool.
8. Salve a configuração, faça uma alteração e restaure a versão salva para confirmar que a reversão funciona.
Próximos passos
Depois das bases, pratique o desenho de monitores e pools para aplicações reais, depois estude os perfis SSL e a renovação de certificados, e por fim os testes de alta disponibilidade. Registre cada alteração feita em virtual servers e pools. A maioria das interrupções vem de mudanças que ninguém registrou, e não de uma única configuração errada.
Resumo
O BIG-IP LTM distribui as requisições dos clientes entre um pool de servidores saudáveis por trás de um único endereço de virtual server. Uma boa configuração começa com o desenho conceitual e o plano de endereços, depois hostname, VLANs, self IPs e rota padrão, em seguida pools com monitores de saúde reais, virtual servers com SNAT, método de balanceamento adequado ao trabalho e, opcionalmente, descarregamento SSL e um par ativo-standby. Salve a configuração antes de cada mudança, e faça a solução de problemas seguindo a ordem do caminho dos dados.