F5 BIG-IP LTM による負荷分散:VLANからフェイルオーバーまでの設定の考え方

F5 BIG-IP Local Traffic Manager(LTM)は、サーバー群の前に置かれ、クライアントのリクエストをサーバーに分散します。どのサーバーが正常かを確認し、必要なときは関連するリクエストを同じサーバーに届け、TLS暗号化をオフロードし、待機中の二台目が自動で引き継ぎます。この記事では、LTMの役割、設計の計画、初回アクセスとネットワーク、プールとヘルスモニター、バーチャルサーバー、分散方式とパーシステンス、SSLオフロード、高可用性、トラブルシューティングを、出会う順番に解説します。設定例では、各手順のtmshコマンドを示します。
必要なもの
IPアドレス、サブネット、VLAN、ルーターとスイッチの役割を理解しておいてください。このサイトのCCNA記事とFortiGate記事にある負荷分散の考え方を読んでおくと役立ちます。練習にはBIG-IPのラボ機器、またはラボ用のvirtual editionを使います。自分が所有している、または設定を許可された機器だけで作業し、本番の負荷分散装置は文書化された計画とロールバック手順なしに変更しないでください。
図解
トピック 1: BIG-IP LTMの役割
ロードバランサーは、サーバー群を一つのサービスのように見せます。クライアントは一つのアドレスに接続し、LTMが各リクエストを処理するサーバーを決めます。これにより処理能力が増え、保守のためにサーバーを外してもサービスを止めずに済み、サーバーの障害をユーザーから隠せます。LTMはトランスポート層とアプリケーション層で動作するため、TCPの詳細やHTTPの内容を判断に使えます。
ロードバランサーを使う理由
一台のWebサーバーが扱えるユーザー数には上限があります。サーバーを追加しても、リクエストを分散する仕組みがなければ効果はありません。LTMは負荷を分散し、各サーバーを確認し、停止したサーバーへの通信を止めます。ユーザーは一つのアドレスだけを見ており、チームはアドレスを変えずにサーバーを入れ替えられます。
ローカルトラフィック管理と他のF5製品
LTMはデータセンター内の通信を分散します。Global Traffic Manager(GTM、現在はDNSベースの負荷分散と呼ばれる)はデータセンター間を選びます。Application Security Manager(ASM、現在はAdvanced WAFと呼ばれる)はWebアプリケーションファイアウォールの機能を加えます。プールやバーチャルサーバーなど同じオブジェクトが他の製品でも使われるため、まずLTMを学んでください。
データの経路
リクエストはバーチャルサーバーのアドレスに届き、プロファイルを通り、プールと照合され、メンバーへ送られます。メンバーからの応答はBIG-IPを通って戻ります。そのため、BIG-IPはクライアントとサーバーの間の経路上にあるか、SNATで戻りの通信を扱う必要があります。
トピック 2: 設定の前に設計を計画する
ロードバランサーの停止の多くは、誰も書き留めなかった設計から生じます。設定ユーティリティを開く前に、ネットワーク、サーバー、ヘルスチェック、フェイルオーバーを計画してください。
構成図を描く
クライアント、外部ネットワーク、BIG-IP、Webサーバーがある内部ネットワーク、スタンバイ機を描きます。各ポートにVLANを、各アドレスに用途(バーチャルサーバーのアドレス、セルフIP、サーバーのアドレス、管理アドレス)を書き込みます。この図が、後の各手順の参照になります。
アドレス計画を書く
ユーザーが接続するバーチャルサーバーのアドレス、各VLANのセルフIP、サーバーのアドレス、デフォルトゲートウェイ、管理アドレスを記録します。管理ネットワークはトラフィックのネットワークと分けて管理します。依存するオブジェクトがすべて書かれていれば、後でアドレスを変えるのも簡単です。
サーバーの確認方法を決める
各サービスについて、サーバーが正常であるとはどういうことかを決めます。WebサーバーはヘルスページへのHTTPリクエストで、データベースはTCP接続で確認できます。ポートだけを確かめるチェックは、壊れたアプリケーションを正常と判断してしまうことがあるため、ユーザーが実際に必要とするものを試してください。
ロールバックを計画する
最初の変更の前に設定を保存し、復元の方法を控えておきます。稼働中のトラフィックを動かす変更には保守時間帯を設け、サービスに依存する人々に知らせます。
トピック 3: 初回アクセス、VLAN、セルフIP、ルーティング
新しいBIG-IPは、トラフィックを流す前にホスト名、DNS、NTP、ライセンス、ネットワーク設定が必要です。設定ユーティリティもコマンドラインも使えます。ここではBIG-IPのコマンドラインツールであるtmshを使います。同じコマンドを保存して繰り返せるからです。
ホスト名、DNS、NTP
bigip01.example.local のような完全な名前を付けます。名前を解決できるようにDNSサーバーを設定し、ログ、証明書、フェイルオーバーのメッセージが正しい時刻を持つようにNTPを設定します。初回ログイン時に既定の管理者パスワードを変更し、個人ごとに名前付きのアカウントを作成します。
VLANをポートに対応づける
VLANはBIG-IP上のネットワークセグメントです。スイッチが期待する形式に応じて、VLANタグの有無を含めて各物理ポートをVLANに割り当てます。外部VLANはクライアントに、内部VLANはサーバーに面します。BIG-IPがこの二つの間で経路選択を行うため、二つのネットワークは分けておきます。
セルフIP
セルフIPは、ヘルスチェックや経路選択などBIG-IP自身の通信に使うVLAN上のアドレスです。各VLANにそのサブネット内のセルフIPを与えます。allow-serviceのdefaultは必要な場所だけに設定し、外部VLANで管理サービスを許可することは決してしないでください。
デフォルトルート
デフォルトルートは、未知の宛先への通信をゲートウェイへ送ります。クライアントとサーバーへのpingで経路を確認します。BIG-IPには届くのに応答を返せないサーバーは、多くの場合サーバー側の経路が欠けているので、サーバーのデフォルトゲートウェイも確認してください。
機器の設定: ホスト名、DNS、NTP、VLAN、セルフIPを設定する
機器に名前を付け、DNSとNTPを設定し、外側と内側のポートをVLANに入れ、各VLANに機器自身の通信に使うセルフIPを与えます。デフォルトルートはISPのゲートウェイへインターネット向けの通信を送ります。設定を保存してから、セルフIPとインターフェースを確認します。
# tmsh: hostname, DNS, NTP, VLANs, self IPs and the default route
tmsh modify sys global-settings hostname bigip01.example.local
tmsh modify sys dns name-servers add { 8.8.8.8 }
tmsh modify sys ntp servers add { pool.ntp.org }
tmsh create net vlan external interfaces add { 1.1 }
tmsh create net vlan internal interfaces add { 1.2 { untagged } }
tmsh create net self 203.0.113.5/24 vlan external allow-service default
tmsh create net self 10.10.10.5/24 vlan internal allow-service default
tmsh create net route default network default gw 203.0.113.1
tmsh save sys config
# Check
tmsh list net self
tmsh show net interface
トピック 4: プール、メンバー、ヘルスモニター
プールは、同じサービスを提供するサーバーのグループです。プールメンバーは、プール内の一台のサーバーとポートです。ヘルスモニターは各メンバーを確認し、稼働中か停止中かを判定するので、BIG-IPは応答できないサーバーにリクエストを送りません。
プールとメンバー
各サーバーとそのポートをメンバーとして追加します。例えば 10.10.10.11:80 です。同じプールのメンバーは同じアプリケーションとコンテンツを持つべきです。BIG-IPは各リクエストを、選んだどのメンバーにも送るからです。サーバーの処理能力が異なるときは、メンバーごとに比率や優先度を設定します。
HTTPモニター
HTTPモニターは、GET /health のようなリクエストを送り、応答に 200 OK のような期待する文字列が含まれるかを確認します。ポートが開いているかだけを確認するモニターより、実際のアプリケーションを確認するモニターのほうがずっと役立ちます。間隔とタイムアウトは、停止したサーバーを素早く外せるように、ただし一度の遅い応答で外れないように設定します。
メンバーの状態
メンバーは、up、down、disabled、forced offline のいずれかになります。disabledは既存の接続を終わらせつつ新しい接続を送らないので、保守の前に便利です。forced offlineは既存の接続も含めてすべての通信を即座に止めます。ユーザーが経験する内容が変わるので、状態は意図して選んでください。
保守のためにサーバーを外す
メンバーを無効にし、接続が減るのを待ち、変更を行い、メンバーを再び有効にして、モニターが up と判定するかを確認します。サーバーを一台ずつ行えば、サービスは動き続けます。
機器の設定: ヘルスモニターとプールを作る
モニターは各サーバーにリクエストを送り、応答が一致したときだけ稼働中とみなします。プールはサーバーをまとめ、モニターを各メンバーに適用し、分散方式を選びます。モニターに失敗したメンバーは、自動的に振り分けから外されます。
# tmsh: a health monitor and a pool with two web servers
tmsh create ltm monitor http web_mon defaults-from http send "GET /health HTTP/1.0\r\n\r\n" recv "200 OK"
tmsh create ltm pool web_pool members add { 10.10.10.11:80 10.10.10.12:80 } monitor web_mon load-balancing-mode round-robin
tmsh save sys config
# Check
tmsh show ltm pool web_pool members
tmsh list ltm monitor http web_mon
トピック 5: バーチャルサーバー、SNAT、プロファイル
バーチャルサーバーは、クライアントが接続するアドレスとポートです。サービスの玄関にあたります。宛先のアドレスとポート、プロトコル、プール、トラフィックの扱いを制御するプロファイル、そして送信元アドレスの変換方法を持ちます。
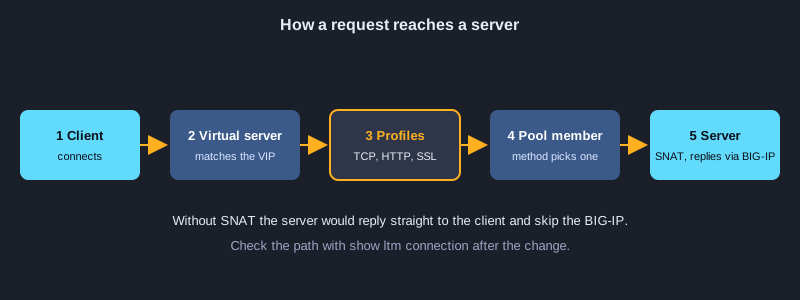
宛先、プロトコル、プール
Webサービスのバーチャルサーバーは、TCPで 203.0.113.10:443 とし、web_pool へトラフィックを送るように設定します。クライアントはこのアドレスだけを使います。プールとそのメンバーはその背後に隠れるので、ユーザーが知っているアドレスを変えずにサーバーを変えられます。
プロファイル
プロファイルはトラフィックの処理方法を制御します。TCPプロファイルは接続を調整し、HTTPプロファイルはリクエストを読んで、LTMがURLやヘッダーで判断できるようにします。クライアント側のSSLプロファイルは暗号化を終端します。サービスに必要なプロファイルだけを使ってください。プロファイルごとに処理が増えるからです。
SNAT automap
送信元の変換がないと、サーバーはクライアントのアドレスを見て、BIG-IPを通らずに直接応答し、接続が切れてしまいます。SNAT automapは送信元を内部VLANのセルフIPに書き換えるので、サーバーはBIG-IPを通じて応答します。show ltm connection で接続を確認し、経路を確かめてください。
バーチャルサーバーをテストする
BIG-IPからだけでなく、実際のクライアントからテストします。バーチャルサーバーの状態を確認し、次にプールとそのメンバーを見ます。バーチャルサーバーは利用可能なのにユーザーがエラーを受けるなら、原因は通常、プロファイル、証明書、またはサーバー上のアプリケーションです。
機器の設定: バーチャルサーバーでプールを公開する
バーチャルサーバーは、クライアントが接続するアドレスです。通信をプールへ送り、プロファイル(TCP、HTTP、クライアント側SSL)を適用し、サーバーの応答がBIG-IPを通るようにSNAT automapを使います。接続はshow ltm connectionで確認します。
# tmsh: a virtual server that publishes the pool on 203.0.113.10:443
tmsh create ltm virtual vs_web destination 203.0.113.10:443 ip-protocol tcp pool web_pool profiles add { tcp http clientssl } source-address-translation { type automap }
tmsh save sys config
# Check
tmsh list ltm virtual vs_web
tmsh show ltm virtual vs_web
tmsh show ltm connection
トピック 6: 分散方式とパーシステンス
分散方式は、新しい接続ごとにどのメンバーが受け持つかを決めます。パーシステンスは、クライアントがいつ同じメンバーに戻り続けるべきかを決めます。例えば、サーバーがユーザーのログインセッションを自分のメモリに保持している場合です。
ラウンドロビンと比率
ラウンドロビンは、メンバーに順番に一つずつ接続を割り当てます。サーバーがすべて同じで、リクエストが似ている場合によく機能します。比率の方式は、性能の高いサーバーに多くの割り当てを与えます。方式はプールに設定します。全ユーザーに適用する前に、数台のクライアントで変更を試せます。
最小接続とレイテンシー
最小接続は、新しいリクエストを、アクティブな接続が最も少ないメンバーへ送ります。処理時間が大きく異なるリクエストに向いています。レイテンシーは、最近最も速く応答したメンバーへリクエストを送ります。方式は、オプションが多いものではなく、サーバーの仕事に合うものを選んでください。
パーシステンス
パーシステンスは、一定時間、クライアントを同じメンバーに留めます。クッキーパーシステンスは、メンバーを識別する値をブラウザに挿入する方式で、Webアプリケーションでよく使われます。送信元アドレスのパーシステンスはクライアントのIPを使いますが、弱い方式です。一つのアドレスの背後にいる多くのユーザーが、すべて同じサーバーに集まってしまうからです。
パーシステンスが問題を起こすとき
停止したメンバーを指すパーシステンスの記録は、記録の期限が切れるまでユーザーのセッションを壊すことがあります。可能な限りパーシステンスのタイムアウトを短くし、失われたセッションからアプリケーションが回復できるようにしてください。
トピック 7: SSLオフロードと証明書
TLSの暗号化と復号は、すべてのサーバーで処理時間を使います。SSLオフロードは、その処理をBIG-IPに移します。BIG-IPが証明書を保持し、クライアントの通信を復号し、内部ネットワーク上のサーバーには平文のHTTPを送ります。内部の通信はネットワーク設計で保護されます。
オフロードの仕組み
クライアント側のSSLプロファイルは、証明書と秘密鍵を保持します。クライアントのTLSセッションはBIG-IPで終わり、BIG-IPがリクエストを読んで、ポート80のメンバーへ転送します。サーバーは公開名の証明書を必要としないため、更新が簡単になります。
証明書と鍵
秘密鍵はBIG-IPにだけ保存し、鍵を書き出せる管理アクセスを保護します。証明書の更新は前もって計画してください。期限切れの証明書は、すべてのユーザーにとってサービスを止めるからです。バーチャルサーバーのアドレスの公開名に一致する証明書を使います。
再暗号化と使うべき場合
内部ネットワーク上でも通信を暗号化したままにする必要があるなら、BIG-IPはサーバー側のSSLプロファイルを使って、サーバーとの間に新しいTLSセッションを開けます。処理は増えますが、データセンター内の通信を保護できます。内部ネットワークを信頼できないときに選びます。
トピック 8: 高可用性とsync-failover
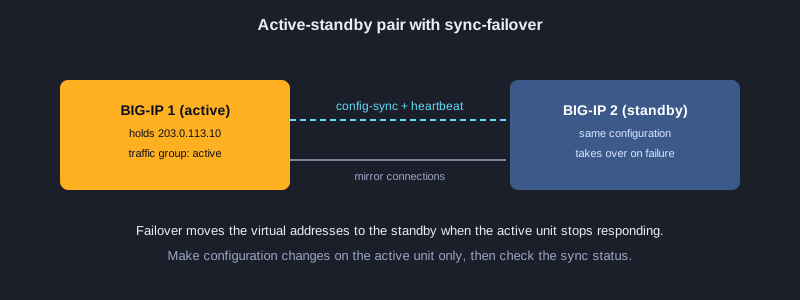
BIG-IPの二台は、アクティブ・スタンバイのペアとして動かせます。スタンバイは同じ設定を持ち、現用機が故障するとバーチャルアドレスを引き継ぎます。フェイルオーバーを正しく設定していれば、クライアントが見るのは通常、停止ではなく短い中断です。
デバイスグループとconfig-sync
sync-failoverのデバイスグループは、設定を共有する機器を並べます。config-syncは、専用ネットワーク経由で変更を一台から他の機器へコピーします。変更は現用機でだけ行い、その後で同期の状態を確認してください。スタンバイでの変更は次の同期で上書きされるからです。
フェイルオーバーの引き金
スタンバイが引き継ぐのは、現用機がハートビートを失ったとき、監視されているトラフィックグループが失敗したとき、または管理者がフェイルオーバーを強制したときです。それぞれの引き金を計画した時間帯にテストし、どのアドレスが移動するか、セッションが維持されるかを確認してください。
サービスを止めずにフェイルオーバーを試す
静かな時間帯に計画したフェイルオーバーを実行し、接続とトラフィックグループを観察します。結果が期待どおりでなければ元に戻します。一度も試していないフェイルオーバーは、保護ではなくリスクです。
機器の設定: アクティブ・スタンバイのsync-failoverを設定する
二台は、専用ネットワーク上のconfig-syncアドレスとミラーアドレスを通じて設定を共有します。デバイスグループが設定を揃え、現用機が故障するとフェイルオーバーで通信が待機機へ移ります。フェイルオーバーは計画した時間帯に試してください。
# tmsh: a sync-failover device group for an active-standby pair (run on the primary unit)
tmsh modify cm device bigip01.example.local configsync-ip 10.10.20.5 unicast-address { { ip 10.10.20.5 } } mirror-ip 10.10.20.5
tmsh create cm device-group failover-group type sync-failover devices add { bigip01.example.local bigip02.example.local } auto-sync enabled
tmsh run cm config-sync to-group failover-group
# Check
tmsh show cm sync-status
tmsh show sys failover
トピック 9: トラブルシューティングと監視
何かが壊れたら、データの経路を順番にたどります。クライアント、バーチャルサーバー、プロファイル、プール、メンバー、サーバーの順です。各段階には、リクエストがその段階まで届いたかを示すコマンドかログがあります。
プールのメンバーから見る
プールのメンバーを表示して、どのサーバーがダウンしているかを確認し、モニターの結果を読みます。モニターがダウンと判定したメンバーは、多くの場合ヘルスチェックが失敗したことを意味します。ユーザーの通信が間違っているとは限りません。負荷分散装置を疑う前に、サーバー上のアプリケーションを確認してください。
ログを読む
LTMログには、モニターの変化、バーチャルサーバーの状態変化、設定エラーが記録されます。障害のたびに読んでください。ログには各イベントの時刻が残るので、ユーザーの報告を変更やサーバー停止と突き合わせられます。
通信をキャプチャする
BIG-IPまたはサーバー上のパケットキャプチャで、リクエストが届いたか、サーバーが何を応答したか、接続がどこで止まったかがわかります。必要な時間だけキャプチャし、ホストとポートで絞り込んでください。負荷の高い機器での全体キャプチャは機器を遅くするからです。
修正を保存して記録する
修正後は設定を保存し、何が失敗し、何を変え、どう確認したかを書き留めます。この記録によって次の調査が短くなり、変更が確認されたことをチームに示せます。
機器の設定: メンバーを確認し、故障したサーバーを切り分ける
ユーザーがエラーを報告したら、プールのメンバーを表示して、どのサーバーがダウンしているかを確認し、LTMログでモニターの結果を読みます。サーバー側のパケットキャプチャで、リクエストがサーバーに届いているか、何を返しているかを確認します。サーバーかモニターを直し、ケースを閉じる前にもう一度確認してください。
# tmsh: check a pool member that is down, then look at the logs and capture the traffic
tmsh show ltm pool web_pool members
tmsh show ltm pool web_pool members detail
tmsh show sys hardware
tail -n 50 /var/log/ltm
tcpdump -ni 0.0:nnn -s0 host 10.10.10.11 and port 80
ラボで練習する
ロードバランサーの技能は実際に手を動かして身につきます。クライアント、中央のBIG-IP、内部ネットワーク上のWebサーバー二台という三つの要素を持つ小さなラボを作ってください。BIG-IPのvirtual editionまたはラボ機器を使い、次の手順を順番に進めます。
1. 構成図を描き、外部と内部のネットワークのアドレス計画を書きます。
2. ホスト名、DNS、NTPを設定し、名前付きの管理者アカウントを作成します。
3. 外部と内部のVLANを作り、それぞれにセルフIPを追加し、デフォルトルートを追加します。
4. クライアントから外部のセルフIPへ、そしてBIG-IPから各Webサーバーへの接続を確認します。
5. HTTPヘルスモニターと、二台のWebサーバーを持つプールを作成します。
6. 外部アドレス上にSNAT automapを付けたバーチャルサーバーを作成し、クライアントから試します。
7. Webサーバーを一台停止し、モニターがダウンと判定するのを確認します。再開して、プールに戻ることを確認します。
8. 設定を保存し、一か所だけ変更してから、保存したバージョンを復元して、ロールバックが機能することを確認します。
次のステップ
基礎の後は、実際のアプリケーション向けにモニターとプールを設計する練習をし、次にSSLプロファイルと証明書の更新を学び、最後に高可用性のテストを行いましょう。バーチャルサーバーとプールへのすべての変更を記録してください。停止の多くは、誰も書き留めなかった変更から起きます。一つの誤った設定値が原因であることは少ないです。
まとめ
BIG-IP LTMは、一つのバーチャルサーバーのアドレスの背後にある、正常なサーバーのプールへクライアントのリクエストを分散します。良い設定は、構成図とアドレス計画から始まり、次にホスト名、VLAN、セルフIP、デフォルトルートを設定し、実際のヘルスモニター付きのプール、SNAT付きのバーチャルサーバー、仕事に合った分散方式を作ります。必要に応じて、SSLオフロードとアクティブ・スタンバイのペアを加えます。変更の前には設定を保存し、データの経路の順序に沿って障害を切り分けてください。